
𝕯𝖆𝖗𝖐🥰𝕬𝖓𝖌𝖊𝖑
МОДЕРАТОР
- Регистрация
- 7 Апр 2025
- Сообщения
- 10,778
- Реакции
- 81
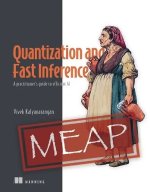
Автор: Vivek Kalyanarangan
Название: Квантизация и ускоренный инференс
Язык: Английский
Вес архива: 78 МБ
«Квантизация и ускоренный инференс» — практическое и прикладное руководство по оптимизации AI‑моделей для более быстрого, лёгкого и экономичного инференса без усложнения архитектуры. Материал помогает понять, как снижение числовой точности вычислений ускоряет работу моделей, уменьшает потребление памяти и снижает стоимость инфраструктуры при минимальной потере качества.
Что вы узнаете из курса
Материал выстроен в виде полного pipeline-а оптимизации — от базовой теории до production‑готовых решений. Книга объясняет ключевые концепции квантизации и демонстрирует, как применять их в реальных ML‑проектах.
Ключевые темы
• Post-training quantization (PTQ) — снижение точности без дообучения;
• Quantization-aware training (QAT) — подготовка моделей к квантизации во время обучения;
• Fake quantization и использование straight-through estimators;
• Работа с LLM: выбросы активаций, оптимизация KV‑cache, форматы ниже 8 бит (NF4, FP4);
• Построение корректного quantization mapping и анализ trade‑off‑ов.
Подход и структура обучения
Книга ориентирована на инженеров и исследователей, работающих с Python и современными ML‑фреймворками. Материал тщательно структурирован и подойдёт как для внедрения квантизации с нуля, так и для оптимизации существующих моделей.
Практическая ориентация
• framework‑agnostic методики и рекомендации;
• кросс‑фреймворк тестирование и сравнение стратегий;
• схемы принятия решений для выбора уровня квантизации;
• чек-листы подготовки моделей к деплою;
• реальные примеры оптимизации больших моделей.
Кому подходит
Материал будет особенно полезен ML‑инженерам, researchers и практикам, стремящимся сократить стоимость инференса, ускорить производство ML‑фич и внедрять современные методы оптимизации моделей без переписывания архитектуры.
СКАЧАТЬ:
📥 Скрытое содержимое! Войдите или Зарегистрируйтесь


