Описание
Количество уроков: 3 Видео
Язык: Русский
Вес архива: 639 МБ
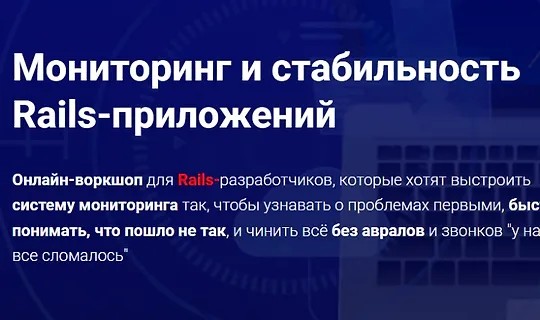
Практический курс, который помогает разработчикам и инженерам выстроить предсказуемый мониторинг, повысить стабильность Rails‑приложений и научиться быстро находить корень проблем в продакшене. Подходит тем, кто хочет перейти от реактивного пожара-тушения к системному контролю состояния сервиса.
Кому пригодится этот курс
Программа ориентирована на инженеров, которые стремятся повысить надежность и управляемость своих продуктов.
• Отвечаете за стабильность всего приложения, а не только отдельных задач.
• Не хватает стройной системы мониторинга, логирования и алертинга.
• Регулярно разбираетесь с инцидентами на продакшене.
• Готовитесь к росту нагрузки или масштабированию команды.
• Хотите, чтобы мониторинг стал реальным инструментом, а не «галочкой».
Программа курса
День 1 — Основы мониторинга
Разбираем ключевые подходы и практики, необходимые для создания прозрачной системы наблюдения за приложением.
• Что и почему нужно мониторить в Rails-приложениях.
• Golden Signals и другие важные метрики.
• Создание первых дашбордов в Prometheus и Grafana.
• Базовые ошибки мониторинга и как их избежать.
Результат: базовая, но полноценная система мониторинга и понимание, какие метрики действительно важны.
День 2 — Алерты и инструменты наблюдаемости
Фокус на инструментах, которые помогают заранее увидеть проблему и правильно на неё отреагировать.
• Сравнение популярных систем мониторинга и их возможностей.
• Принципы настройки алертов: шумоподавление, пороги, приоритеты.
• Трассировка запросов: как искать медленные участки и точки деградации.
• Интеграция мониторинга с командными процессами.
Результат: умение выстраивать эффективные уведомления и находить проблемы ещё до того, как они станут инцидентами.
День 3 — Инцидент-менеджмент и устойчивость
День посвящён продвинутым практикам стабильности и работе с инцидентами на уровне команды и продукта.
• Процессы разбора инцидентов и понятный постмортем.
• SLA, SLO, SLI — как договориться с бизнесом и пользователями.
• Нагрузочное тестирование: подготовка к пикам нагрузки.
• Хаос‑тестирование и проверка устойчивости системы.
Результат: чёткая структура управления инцидентами и инструментарий для повышения стабильности Rails‑приложения.
Что вы получите после прохождения
• Понимание современной практики наблюдаемости (observability) в веб‑приложениях.
• Набор дашбордов, алертов и процессов, которые можно сразу применять в работе.
• Умение снижать время реакции на инциденты и повышать стабильность сервиса.
• Системный подход к мониторингу и работе с производительностью.
Почему это важно
С ростом нагрузки и усложнением архитектуры именно мониторинг определяет, насколько быстро команда сможет реагировать на сбои. Хорошая система наблюдаемости делает продукт предсказуемым, а команду — более эффективной. Курс даёт практические инструменты, которые можно внедрять поэтапно и без сложной доработки инфраструктуры.
Алексей –
Я больше практик и не люблю долгие лекции, но тут материал плотный и по делу. Уже на первой неделе после курса выкатил дашборд по ключевым метрикам и настроил пара алертов с нормальными порогами вместо шума. Разбор типичных ошибок мониторинга зашёл отдельно, многое узнал у себя. Теперь инциденты на продакшене разбираем спокойнее.
Дмитрий К. –
Опыт в Rails около пяти лет, и по мониторингу было много интуитивного, но без системы. Второй день про алерты оказался самым полезным: шумоподавление, пороги и приоритеты наконец разложены по полочкам. Трассировка запросов тоже пригодилась на реальной задаче с медленным эндпоинтом. Хотелось бы больше времени на практику по трассировке, за четыре часа всё-таки тесновато.
Марина В. –
Брала курс, потому что у нас в команде мониторинг был скорее формальностью. За первый день наконец разобралась с Golden Signals и собрала свои первые дашборды в Prometheus и Grafana. Понравилось, что объясняют не только как настроить, но и какие метрики действительно стоит смотреть. После курса пересмотрела наши графики и убрала лишнее.